 BTC
谷歌量子AI“Willow”处理器在贝尔姆-佩雷斯魔方游戏中展现98.30%胜率
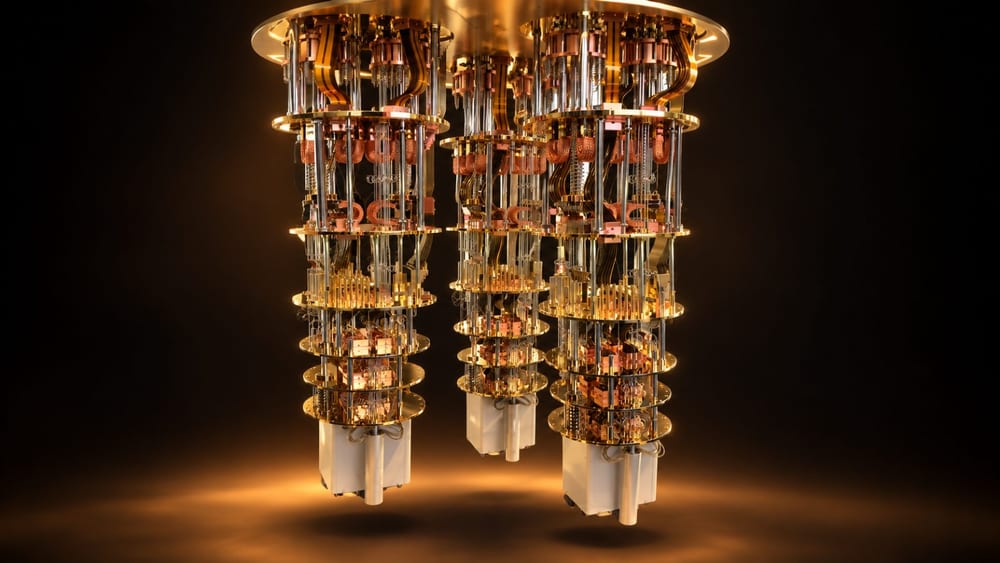
谷歌量子AI(Google Quantum AI)的超导量子处理器“Willow”在4个量子比特上进行的贝尔姆-佩雷斯(Mermin-Peres)魔方游戏测试中,取得了98.30%的胜率。这一结果超越了经典策略理论上的上限88.89%。
1月19日,谷歌量子AI在其官方研究博客中公开了此次实验成果。相关的研究论文同日发表在《科学》(Science)杂志封面上。
魔方游戏规则与经典局限
魔方游戏是一种合作游戏,参与者需在3×3网格的每个单元格中填入+1或-1。一名参与者负责填写行,另一名参与者负责填写列,双方不得进行通信。规则要求所有行的乘积为+1,所有列的乘积为-1。由于预先约定的经典策略无法在所有九种组合中同时满足条件,因此至少会有一次失败,导致胜率无法超过88.89%。
研究团队对9种游戏组合各执行了10万次运行。统计结果显示,Willow处理器的总体胜率为0.9830±0.0001。谷歌方面解释称,主要的误差来源是硬件中残留的噪声。
聚焦量子语境性验证
本次实验的核心在于测量“量子语境性”(Quantum Contextuality),即量子测量结果可能依赖于测量上下文(即同时测量的其他可观测量)的性质。研究团队通过贝尔-科亨-斯佩克尔(Bell-Coleman-Specker)不等式对量子语境性进行了量化评估。
Willow处理器的得分为χ=5.590±0.008,虽然超过了经典上限4,但未达到量子理论预测的最大值6。Willow利用两对纠缠量子比特,使交叉单元格的回答以高于经典上限的概率保持一致,从而直接证实了在不同测量条件下装置产生的相关性。
大规模量子比特实验进展
此外,单独的GHZ奇偶性游戏实验扩展至最多71个量子比特,其中确认有45个量子比特处于真正的纠缠状态。随着量子比特数量的增加,噪声也随之增大,导致与经典策略的优势差距缩小,但结果仍持续超越经典上限。
在隐藏线性函数问题(Hidden Linear Function Problem)实验中,使用了多达105个量子比特。尽管正确答案的概率约为0.6(略高于随机猜测的0.5),但由于该规模下的经典比较基准尚未在数学上完全确定,仅凭此实验尚难确切界定量子优势的具体量级。目前的基准主要基于研究团队的估算和推测。
实验意义与行业观点
谷歌表示,魔方和GHZ实验旨在作为衡量量子处理器性能的固定物理基准,而非仅仅展示商业算法的优势。这种需要多个量子比特同时精确协作的结构化电路,能够揭示出随机电路测试可能遗漏的细微错误。谷歌指出,此类结构化电路的质量评估可用于检查分子和材料模拟所需的量子电路,但本次研究并未直接执行化学或材料计算任务。
媒体对此也进行了客观报道。《The Quantum Insider》指出,105量子比特隐藏线性函数实验的经典比较基准仍依赖推测;《The Next Web》则强调,该论文并未声称对所有经典计算机具有无条件优势,也不是直接执行化学或材料计算的实验。
此前,相关报道曾提及Willow将魔法态生成错误率降低了约40倍。当时的研究同样侧重于在实际量子芯片上降低错误率和提高硬件可靠性,而非单纯追求通用计算能力。
未来展望
本次研究未涉及比特币(BTC)或其他区块链密码密钥破解、密码体系崩溃时间点或加密货币价格影响等内容,其重点在于测量量子语境性和硬件错误的方法。要实现实际应用的判断,仍需减少残留噪声,并在数学上确立105量子比特实验的经典比较基准。本次研究标志着在同时测量量子语境性和硬件错误方面迈出了重要一步。

















 交易所
 交易所排行榜
 24小时成交排行榜
 人气排行榜
 交易所比特币余额
 交易所资产透明度证明
 去中心化交易所
 资金费率
 资金费率热力图
 爆仓数据
 清算最大痛点
 多空比
 大户多空比
 币安/欧易/火币大户多空比
 Bitfinex杠杆多空比
 ETF追踪
 索拉纳ETF
 瑞波币ETF
 香港ETF
 比特币持币公司
 加密资产反转
 以太坊储备
 HyperLiquid钱包分析
 Hyperliquid鲸鱼监控
 大额转账
 链上异动
 比特币回报率
 稳定币市值
 期权分析
 新闻
 文章
 财经日历
 专题
 钱包
 合约计算器


 账号安全
 资讯收藏
 自选币种
 我的关注